PRESSEMITTEILUNG · RHEINE (MÜNSTERLAND), NOVEMBER 2026 · SPERRFRIST: FREI ZUR SOFORTIGEN VERÖFFENTLICHUNG
Auswertung von 10.648 deutschen Websites: 94,1 Prozent nennen ihre Anschrift im Text – doch bei 73,0 Prozent fehlt maschinenlesbares Unternehmens-Markup
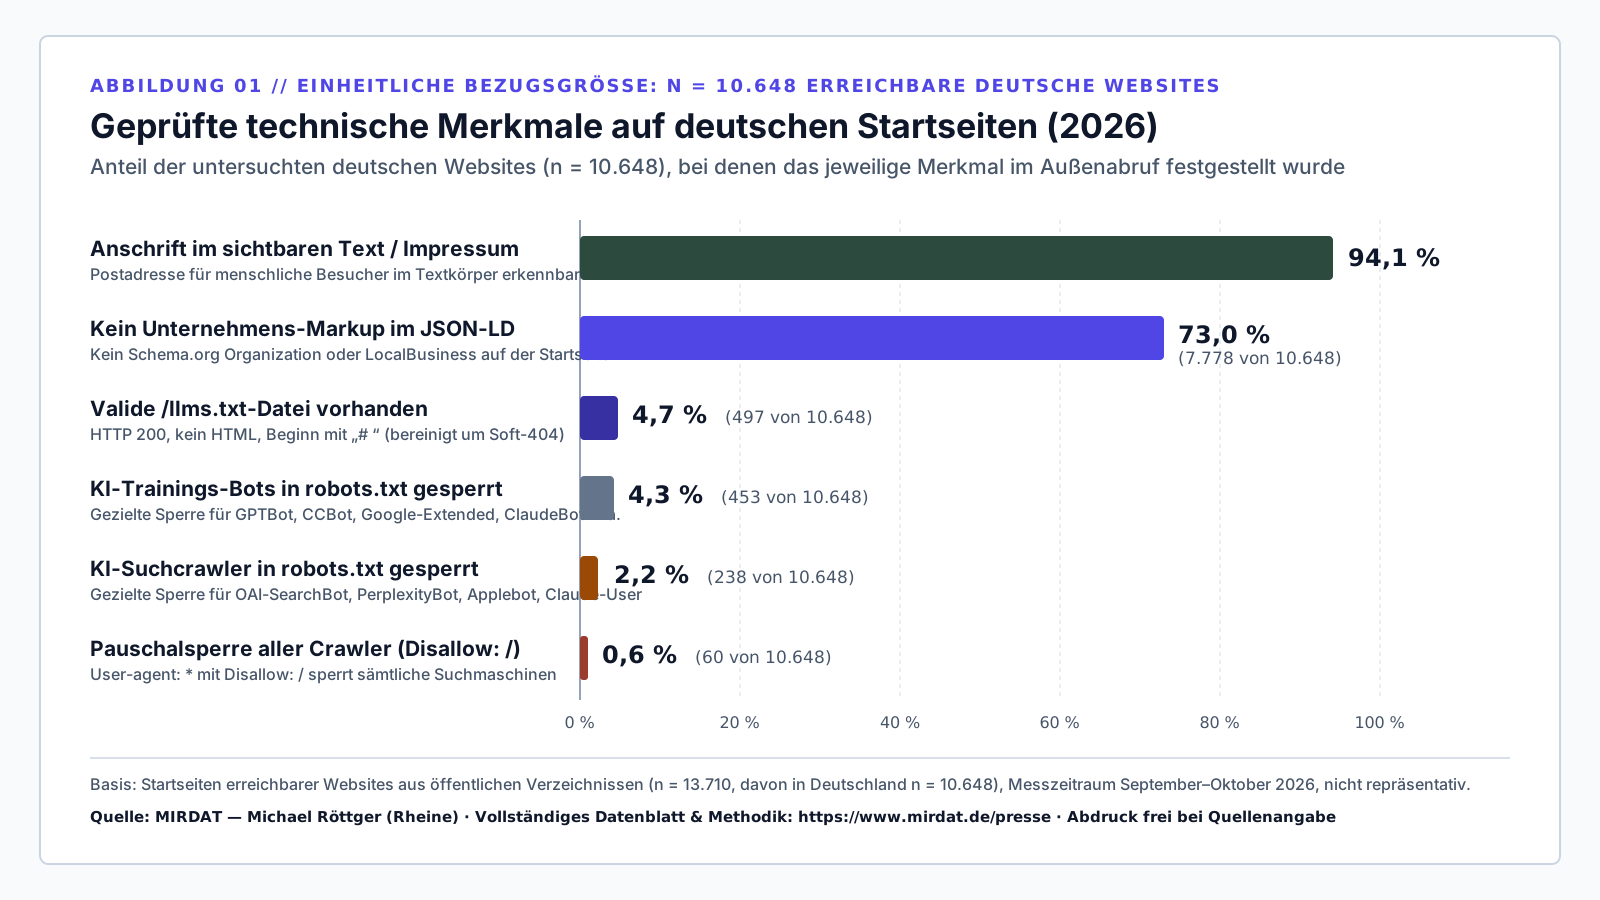
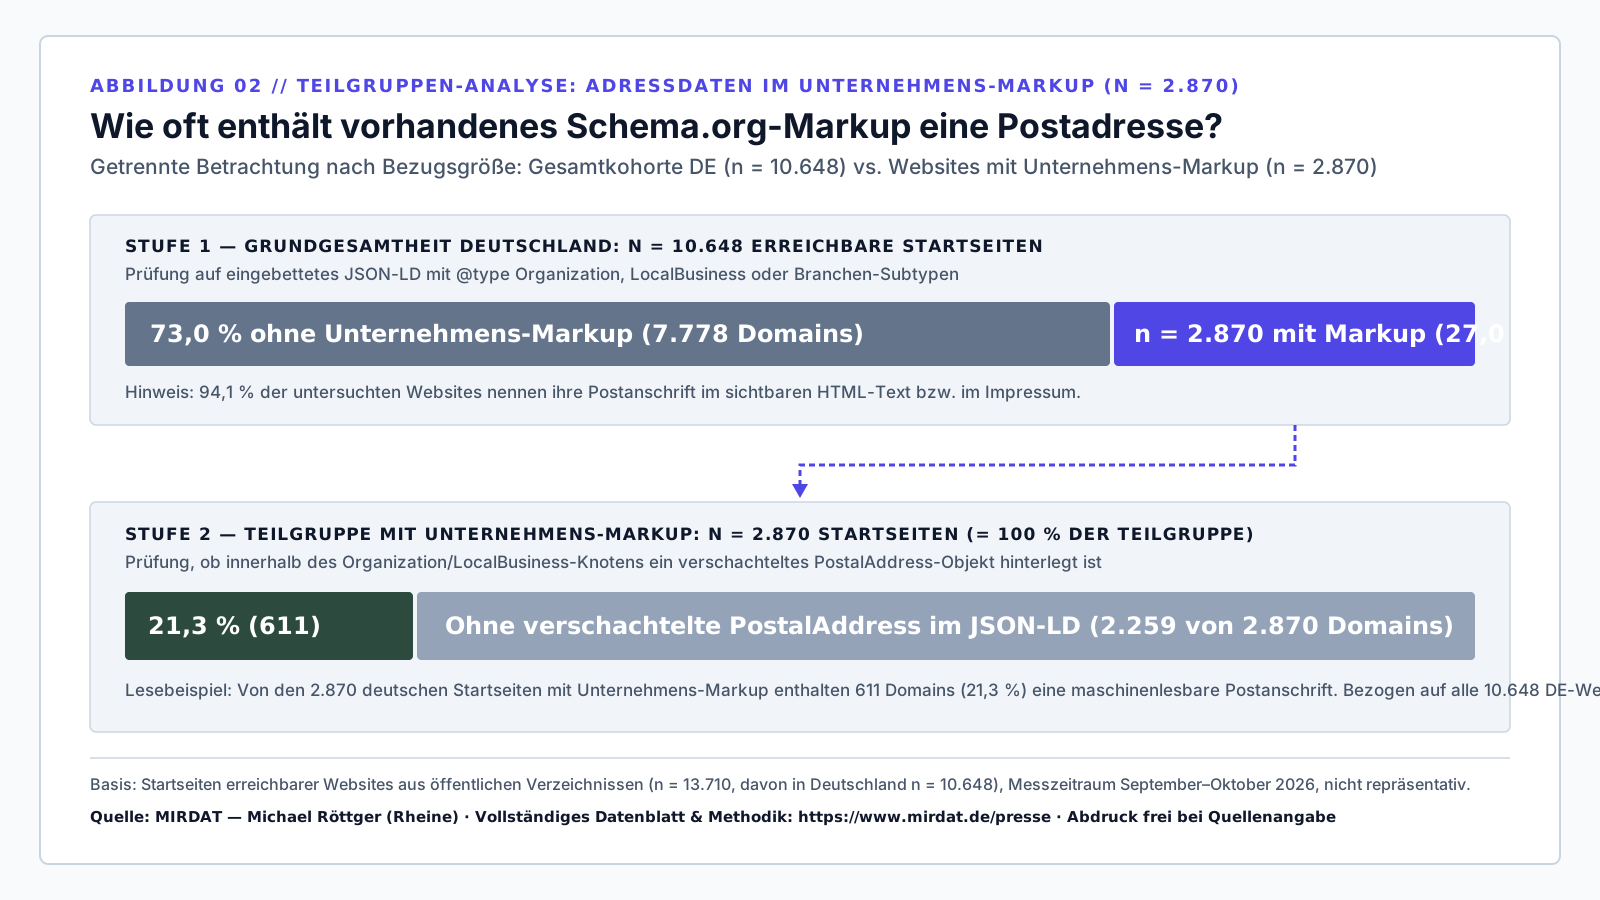
Rheine. Fast jedes untersuchte Unternehmen in Deutschland nennt seine Postanschrift ordentlich im sichtbaren Text oder im Impressum (94,1 %). Im technischen Quellcode fehlt jedoch auf knapp drei Vierteln der untersuchten Startseiten (73,0 % bzw. 7.778 von 10.648 Domains) ein strukturiertes Unternehmens-Markup nach Schema.org (Organization oder LocalBusiness). Selbst unter den 2.870 deutschen Websites, die ein solches Unternehmens-Markup im JSON-LD-Format einsetzen, hinterlegen nur 21,3 % (611 Domains) darin eine verschachtelte Postadresse (PostalAddress). Das zeigt eine technische Auswertung des Rheiner Software-Anbieters MIRDAT, für die im September und Oktober 2026 insgesamt 13.710 technisch erreichbare Websites aus öffentlichen Verzeichnissen (davon n = 10.648 in Deutschland) automatisiert untersucht wurden.
Wenig aktive Bot-Sperren – aber große Lücken in der Datenstruktur
In der Diskussion über KI-gestützte Suchsysteme wie ChatGPT Search, Perplexity oder Google Gemini wird häufig vermutet, dass Unternehmen automatisierte Abruf-programme aktiv aussperren. Die Untersuchung der jeweiligen /robots.txt-Dateien bestätigt dies für deutsche Websites kaum: Lediglich 2,2 % der untersuchten deutschen Domains (239 von 10.648) blockieren gezielt KI-Such- und Retrieval-Crawler wie OAI-SearchBot, PerplexityBot, Applebot oder Claude-User (97,8 % bzw. 10.409 Domains ungesperrt). Etwas häufiger – nämlich bei 4,3 % (453 Domains) – werden reine Trainings-Crawler wie GPTBot, CCBot oder Google-Extended vom Einsammeln von Trainingsdaten ausgeschlossen. Eine pauschale Komplettsperre sämtlicher Suchmaschinen (User-agent: * mit Disallow: /) fand sich bei 0,6 % (60 Domains).
Technische Einordnung: Was fehlendes Markup bedeutet – und was nicht
MIRDAT weist ausdrücklich darauf hin, dass ein fehlendes Schema.org-Markup oder eine fehlende /llms.txt-Datei nicht automatisch bedeutet, dass ein Unternehmen in Suchmaschinen oder KI-Antworten unsichtbar ist. So dokumentiert etwa Google für seine KI-Suchfunktionen, dass weder spezielle KI-Textdateien noch gesonderte Schema-Auszeichnungen zwingende Voraussetzung für eine Aufnahme sind. Strukturierte JSON-LD-Auszeichnungen erleichtern automatisierten Systemen jedoch die eindeutige Zuordnung von Unternehmensname, Standort, Branche und Öffnungszeiten; bei 73,0 % der Domains liegen diese Angaben jedoch nicht zusätzlich in der geprüften strukturierten Form vor.
Bei dem noch jungen Dateiformat /llms.txt – einer kompakten Markdown-Übersicht für automatisierte Systeme – zeigte sich zudem ein deutlicher Unterschied zwischen oberflächlicher Erreichbarkeit und echtem Inhalt: Nachdem sogenannte Soft-404-Seiten (etwa Shopsysteme, die bei nicht vorhandenen Dateipfaden trotzdem den HTTP-Status 200 samt HTML-Startseite ausliefern) herausgefiltert wurden, verfügten 4,7 % der untersuchten deutschen Websites (497 von 10.648) über eine valide Markdown-Datei unter /llms.txt (vor Filterung von Soft-404-Seiten oberflächlich 9,7 % bzw. 1.030 Domains).
„In den meisten Betrieben sind die Angaben zu Standort und Leistungen längst vorhanden – sie stehen im Impressum oder auf der Kontaktseite für menschliche Besucher. Im Quelltext fehlen jedoch häufig strukturierte Schema.org-Auszeichnungen wie die PostalAddress oder maschinenlesbare Übersichten wie die llms.txt. Wer seine Website technisch sauber strukturiert, nimmt automatisierten Such- und Antwortsystemen unnötige Interpretationsarbeit ab.“— Michael Röttger, Inhaber und Software-Entwickler von MIRDAT in Rheine
Basis: Startseiten erreichbarer Websites aus öffentlichen Verzeichnissen (n = 13.710, davon in Deutschland n = 10.648), Messzeitraum September–Oktober 2026, nicht repräsentativ.